AI coding agenti se dostali do bodu, kdy už není příliš zajímavé řešit, zda dokážou psát produkční kód. Dokážou. Mnohem složitější otázkou je, jak jejich práci správně organizovat.
Nějakou dobu byl náš workflow ve Studio81 Labs poměrně jednoduchý: zadat schopnému coding agentovi feature, nechat ho projít repository, vytvořit plán, implementovat změny, spustit testy, opravit problémy a otevřít pull request. Funguje to překvapivě dobře. Zároveň je to překvapivě neefektivní.
High-reasoning model, který má velkou hodnotu při architektonických rozhodnutích, nemusí zbytek svého context window trávit koordinací rutinních změn souborů, čtením výstupů testů, opravami lintu nebo dohledem nad levnějšími subagenty. Jakmile jsme začali pracovat na více projektech a features současně, přestal to být pouze teoretický problém. Agent compute se stal zdrojem, se kterým má smysl zacházet systematicky.
Začali jsme proto k AI-assisted development přistupovat méně jako ke konverzaci s jedním velmi schopným vývojářem a více jako k software delivery pipeline. Výsledkem je workflow postavený kolem čtyř rolí:
Architekt → Orchestrátor → Workeři → Reviewer
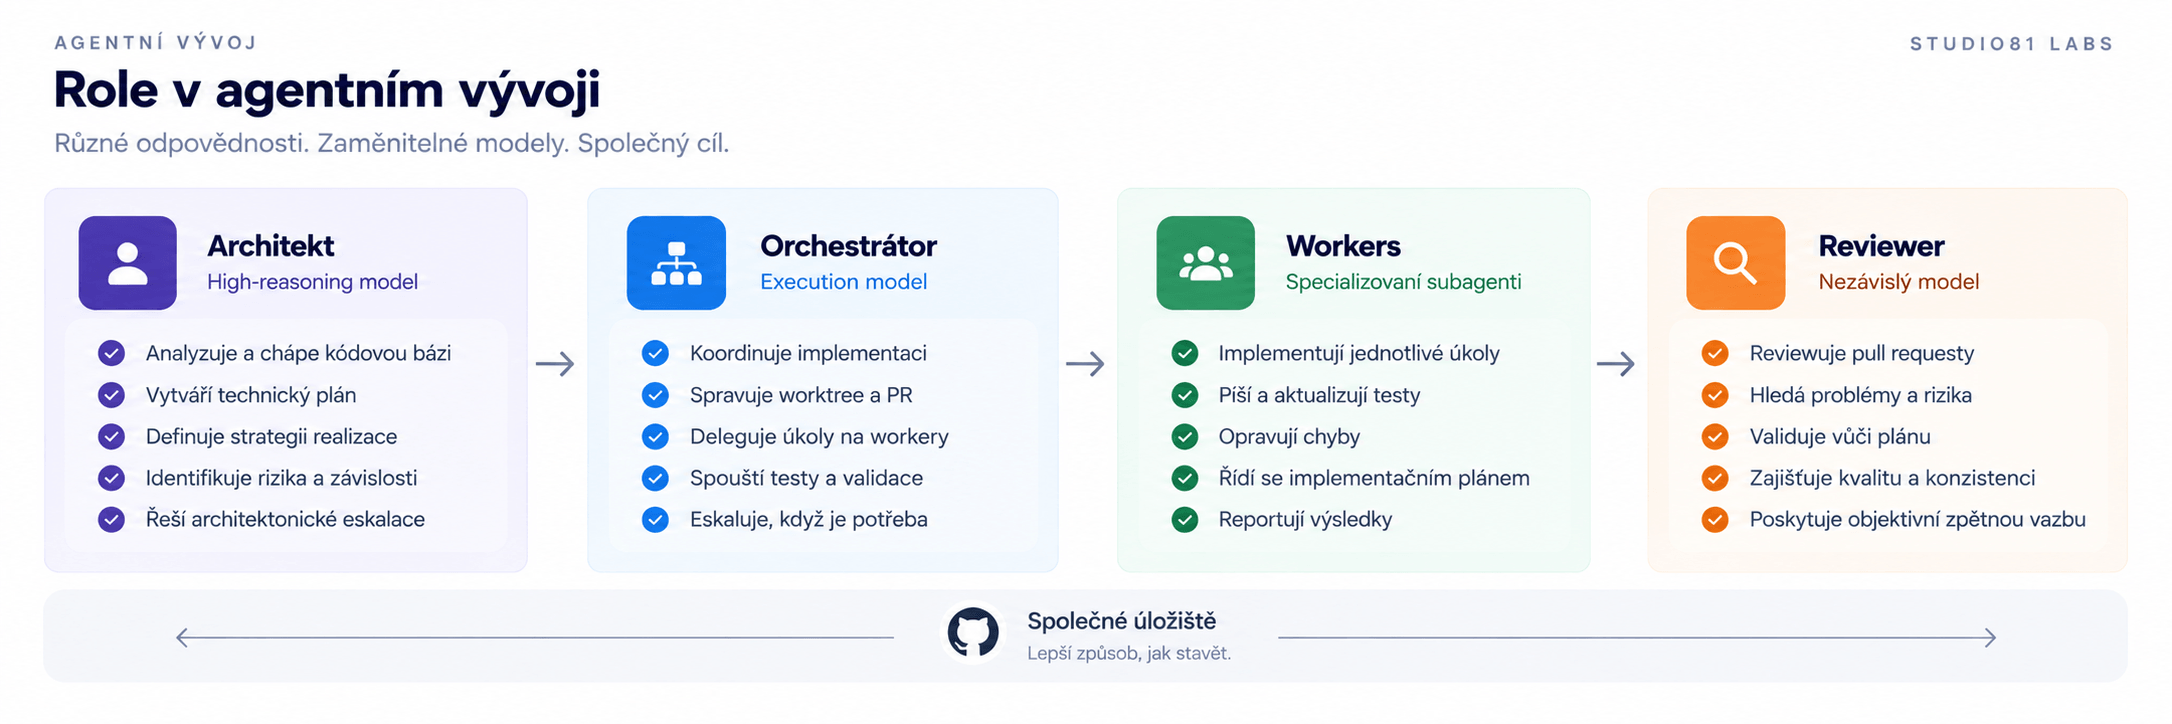
Důležité je, že jde o role, nikoliv názvy modelů. Dnes může být architektem GPT-5.6 Sol, Claude Opus nebo Fable; orchestrátorem Claude Sonnet, GPT-5.6 Terra nebo Gemini. Zítra budou nejlepší volby pravděpodobně jiné. Workflow by měl tuto změnu přežít.
Problém workflow s jedním agentem
Typický autonomní coding task vypadá přibližně takto:
Nápad → analýza repository → architektonický reasoning → implementační plán
     → implementace → orchestrace subagentů → testy → opravy → pull request
Na takovém postupu není nic zásadně špatného. Problém je v tom, že každá fáze běží přes stejný reasoning context a často také přes stejný drahý model. Model, který před chvílí hluboce analyzoval hranice domény a architekturu systému, je stále ve službě ve chvíli, kdy worker oznámí, že tři testy selhaly kvůli mocku, který je potřeba aktualizovat. To je plýtvání schopnostmi modelu.
Subagenti pomáhají, ale problém úplně neřeší. I když workeři používají menší optimalizované modely, parent agent je stále musí koordinovat, zpracovávat jejich výsledky, udržovat kontext, rozhodovat o dalších krocích a integrovat jejich práci.
Naše první změna proto byla jednoduchá: oddělit reasoning od execution.
Fáze 1: architekt
Významnější feature začíná u high-reasoning modelu — jeho úkolem ale není psát kód. Jeho úkolem je udělat implementaci nudnou.
Než architekt začne pracovat, máme už product-level plánování v GitHubu. Větší feature nebo rozsáhlejší bug vznikne jako Epic s child issues, které popisují požadované chování a acceptance criteria. Například:
Epic: Multi-device support
 ├─ registrace zařízení
 ├─ identita a recovery
 ├─ synchronizace
 ├─ lokální persistence
 └─ řešení konfliktů
Tyto issues popisují, co chceme vytvořit. Architekt řeší, jak to vytvoříme. Přečte celý Epic a jeho child issues, ale také skutečný repository, architektonickou dokumentaci, ADR a existující patterns. Tento rozdíl je důležitý. Agent by neměl navrhovat systém pouze podle product issue, pokud codebase obsahuje omezení, o kterých autor issue vůbec nevěděl.
Architekt následně rozšíří Epic o technický implementační plán: cílovou architekturu, dotčené moduly, změny dat a persistence, API a contracts, dependencies, migrace a backward compatibility, testovací strategii, hranice PR, integrační validaci a escalation criteria.
Zároveň rozhodne, jakým způsobem má implementace proběhnout: sériově, paralelně, nebo hybridně. Multi-agent systémy svádějí k paralelizaci. Pokud máme k dispozici pět agentů, proč jim rovnou nerozdat pět issues? Protože paralelizace není zadarmo. Více agentů může zkrátit celkovou dobu implementace, ale zároveň zvýšit spotřebu compute, náklady na koordinaci, množství merge konfliktů a pravděpodobnost, že jednotliví agenti začnou dělat nezávislá architektonická rozhodnutí, která se postupně rozejdou.
Execution strategy proto považujeme za explicitní výstup plánování. Serial používáme pro silně provázanou nebo architektonicky nejistou práci. Parallel pro nezávislé úkoly se stabilními interfaces. Hybrid pro nejčastější případ — nejprve společný základ, následně paralelní nezávislá práce a nakonec integrační fáze.
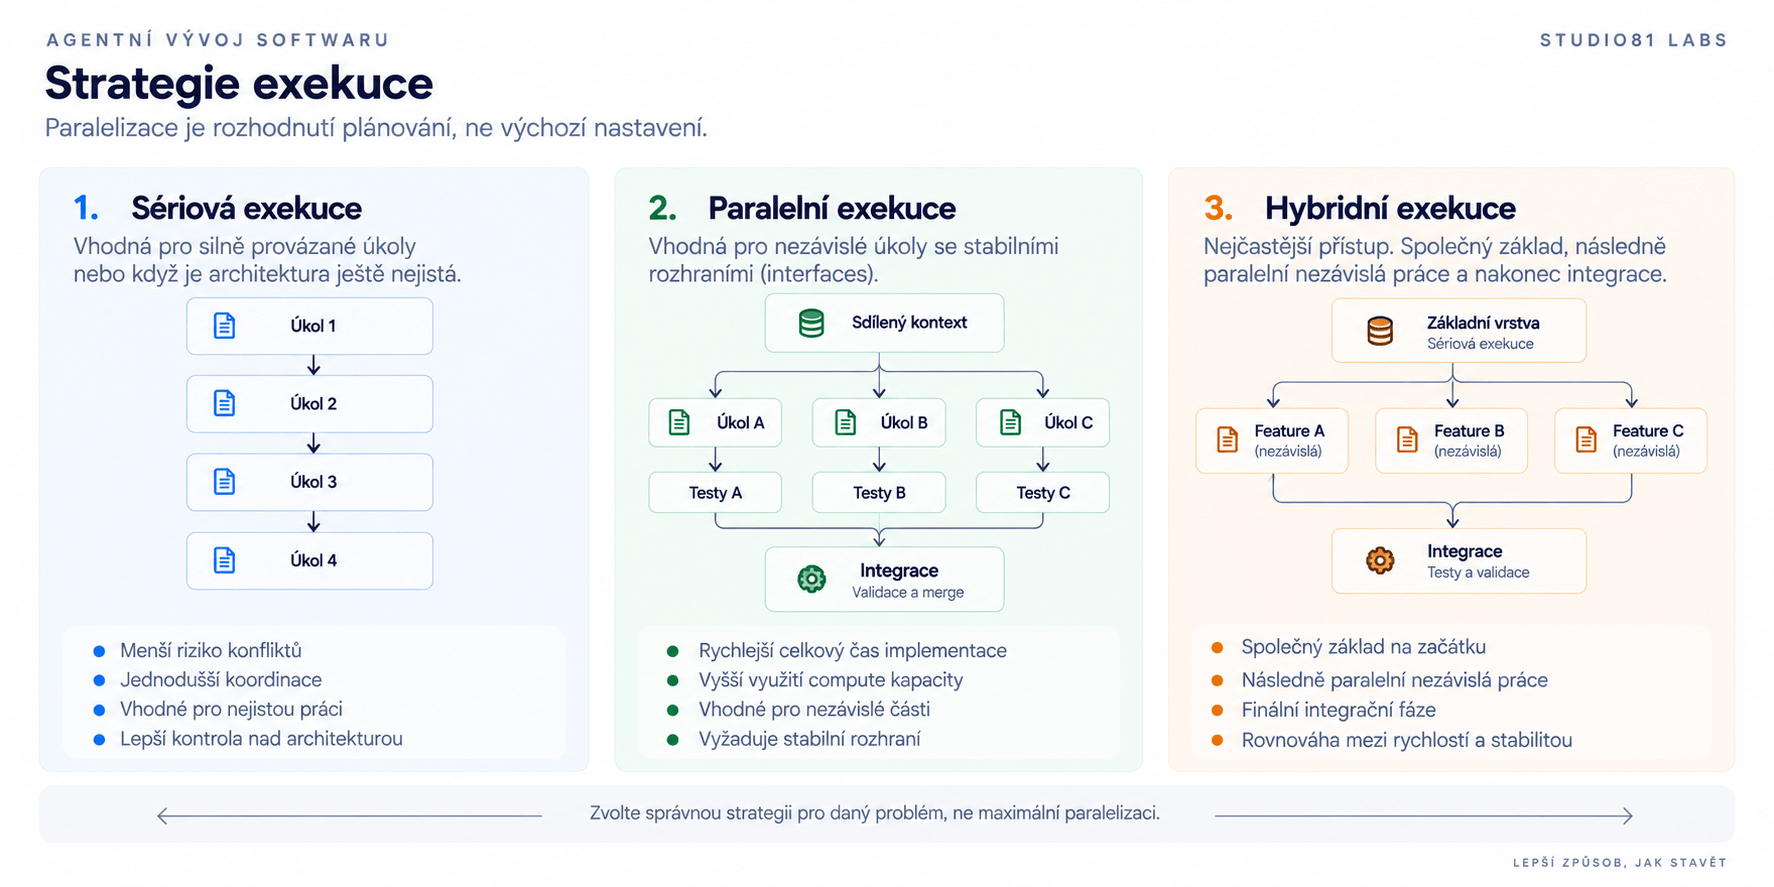
Cílem není maximální paralelizace. Cílem je užitečná paralelizace. Součástí rozhodování je i compute budget. Několik orchestrátorů, z nichž každý současně spouští vlastní workery, dokáže agent quota vyčerpat překvapivě rychle.
GitHub je koordinační vrstva
První verze našeho workflow používala Markdown soubory uvnitř Git worktrees. Architekt vytvořil plán, orchestrátor ho načetl a pokud implementace odhalila problém, orchestrátor vytvořil escalation Markdown soubor pro architekta. Koncepčně čisté. V praxi mají současné agentní nástroje různé modely vlastnictví sessions a worktrees. Worktree vytvořený jednou session nemusí být možné připojit k jiné a změna modelu uvnitř existující session může zhoršit práci s kontextem.
Zjistili jsme, že po Git worktrees chceme řešení dvou nesouvisejících problémů. Proto jsme je oddělili:
- Git worktrees poskytují izolaci implementace.
- GitHub Issues zajišťují koordinaci agentů.
Worktree tedy patří jednotce práce, nikoliv konkrétnímu agentovi. Agenti pracující na daném úkolu se mohou měnit, a worktree proto zároveň nemůže být jejich komunikačním kanálem. Pokud koordinaci držíme v GitHubu, workflow není závislý na runtime konkrétního agenta.
Po dokončení plánování architekt vytvoří pod Epicem implementation child issue. Obsahuje pořadí implementace, dependencies, očekávané hranice PR a odkaz na technický plán. Orchestrátor pak může začít v úplně nové session, s jiným modelem, a dokonce v úplně jiném nástroji. Jeho vstupním bodem je jednoduše GitHub issue. Žádná historie předchozí konverzace nemusí handoff přežít.
Fáze 2: orchestrátor
Orchestrátor dostane implementation issue, přečte parent Epic a jeho plán, projde child issues a vytvoří izolovaný worktree pro implementaci. Jeho odpovědnost je zásadně odlišná od architekta. Architekt navrhuje. Orchestrátor dodává.
Implementation issue → Orchestrátor → [ Worker · Worker · Worker ] → testy → PROrchestrátor koordinuje implementaci, deleguje jasně ohraničené úkoly workerům, spouští testy a validaci, vytváří pull requesty a udržuje vazbu mezi změnami v kódu a GitHub issues. Může dělat běžná implementační rozhodnutí — naming, interní organizaci kódu, strukturu testů, přímočaré refactoringy a technické detaily uvnitř již schválených contracts. Co ale dělat nesmí, je potichu redesignovat feature. K tomu slouží eskalace.
Fáze 3: eskalace
Tohle se stalo jednou z nejdůležitějších částí celého workflow.
Žádný implementační plán nepřežije kontakt s dostatečně komplikovanou codebase beze změny. Worker může zjistit, že existující persistence invariant koliduje s navrženým řešením. API může mít požadavky na backward compatibility, které během plánování nebyly zřejmé. Nebo se ukáže, že některý předpoklad o lifecycle systému jednoduše neplatí.
Běžným chováním agentů je nově objevený problém jednoduše vyřešit. Někdy správně. Jindy tím agent schová zásadní architektonické rozhodnutí hluboko do implementačního diffu. To nechceme. Naše pravidlo proto zní:
Levnější model může architektonický problém objevit. Nemá ale automaticky oprávnění ho vyřešit.
Pokud implementace narazí na problém týkající se architektury, persistence, veřejných contracts, security, concurrency nebo backward compatibility — zkrátka něčeho, co zásadně zneplatňuje schválený plán — práce na dotčené části se zastaví. Orchestrátor otevře nový GitHub child issue, například:
[ESCALATION] Conflict between device identity
             and existing recovery semantics
Issue obsahuje kontext, původní předpoklad, skutečný stav nalezený během implementace, relevantní části kódu, známé varianty řešení a konkrétní rozhodnutí, které je potřeba udělat. Architekt se pak může vrátit do své původní high-reasoning session s velmi krátkým promptem: Resolve escalation #157. Provede deep reasoning pouze nad tímto problémem, zapíše resolution a v případě potřeby aktualizuje technický plán. Orchestrátor si přečte uložené rozhodnutí a pokračuje.
Drahý reasoning model se tak používá přesně tam, kde má jeho schopnost odpovídající hodnotu — a nikde jinde.
Fáze 4: nezávislé review
Také nechceme, aby byl implementační model konečnou autoritou nad vlastní prací. Pull request proto prochází nezávislým review, ideálně modelem z jiné modelové rodiny. Například:
Gemini implementace → Codex review → Gemini fixes → Codex review → human validationRůzné modelové rodiny mají různé failure modes. Pokud stejný model implementuje, kontroluje a následně schvaluje vlastní architektonické předpoklady, získáváme menší diverzitu než při použití jiného systému jako reviewera. Reviewer nepotřebuje přístup k implementační session. Jeho rozhraním je pull request. Pokud review objeví implementační chybu, opraví ji orchestrátor. Pokud odhalí nový architektonický problém, projde stejným escalation mechanismem.
Reálný experiment: HomeKit pro Smart Panel
Nedávno jsme dostali příležitost ověřit, jestli tento přístup funguje i mimo diagramy. Náš projekt FastyBird Smart Panel potřeboval nativní integraci s Apple Home. Feature byla dostatečně rozsáhlá, aby šlo o zajímavý test: HomeKit bridge, detekce kompatibility zařízení, mapování accessories, pairing, persistence, obousměrná synchronizace stavu a administrační UI.
Pro implementaci jsme použili Google Antigravity 2.0 s Gemini. Výsledek nás překvapil. Agent vytvořil integraci velmi rychle, včetně administračního flow, ve kterém si uživatel explicitně vybírá, která Smart Panel zařízení chce zpřístupnit do Apple Home. Nepodporovaná zařízení jsou identifikována ještě před párováním namísto toho, aby tiše selhala. Codex implementaci několikrát nezávisle zkontroloval. Gemini následně vyřešilo nalezené problémy.
Pak jsme se posunuli za hranici agent-generated testů. Bridge se úspěšně spároval s Apple Home. Ověřili jsme administrační UX a opravili drobné product a UX problémy, které coding agenti stále běžně přehlížejí. Pomocí simulatoru jsme otestovali kompletní command path. Nakonec jsme plugin nasadili do živé testovací instalace s reálnými zařízeními. Zařízení se objevila v Apple Home a jejich ovládání fungovalo obousměrně a responzivně.
To změnilo náš pohled na Antigravity. Původně jsme ho brali jako experiment vedle Claude Code a Codexu. Poté, co skutečná integrace prošla nezávislým review a validací na fyzických zařízeních, začalo dávat smysl považovat ho za další produkčně použitelný execution environment.
Ještě důležitější ale bylo potvrzení architektury samotného workflow. Důležitou abstrakcí nebylo: Gemini napsalo feature. Bylo jí:
Plánování → implementační agent → nezávislé modelové review
        → fix cycle → lidská UX validace → validace na reálném hardware
Konkrétní model přiřazený ke kterékoliv z těchto rolí se může změnit.
Člověk je stále součástí pipeline
HomeKit experiment zároveň ukázal, kde má manuální práce stále významnou hodnotu. Vygenerované administrační UI bylo překvapivě dobré. Nebylo perfektní. Některé UX detaily dávaly technicky smysl, ale nezapadaly do zbytku produktu tak dobře, jak by měly. Během manuální validace jsme je upravili.
Claude, Codex i Gemini vykazují různé varianty stejného chování. S dostatečně detailní UI specifikací a design systémem se agenti dokážou dostat překvapivě blízko. Product judgment ale stále není snadné kompletně zakódovat. Naše pipeline proto končí něčím, co agenti zatím nedokážou plně nahradit: validací v reálném světě. Použít UI. Spárovat skutečný iPhone. Ovládat fyzické zařízení. Otestovat nepříjemný recovery flow. Nebo se jednoduše zeptat, jestli feature působí konzistentně se zbytkem produktu. Úspěšné unit testy nejsou totéž jako dobře dodaná feature.
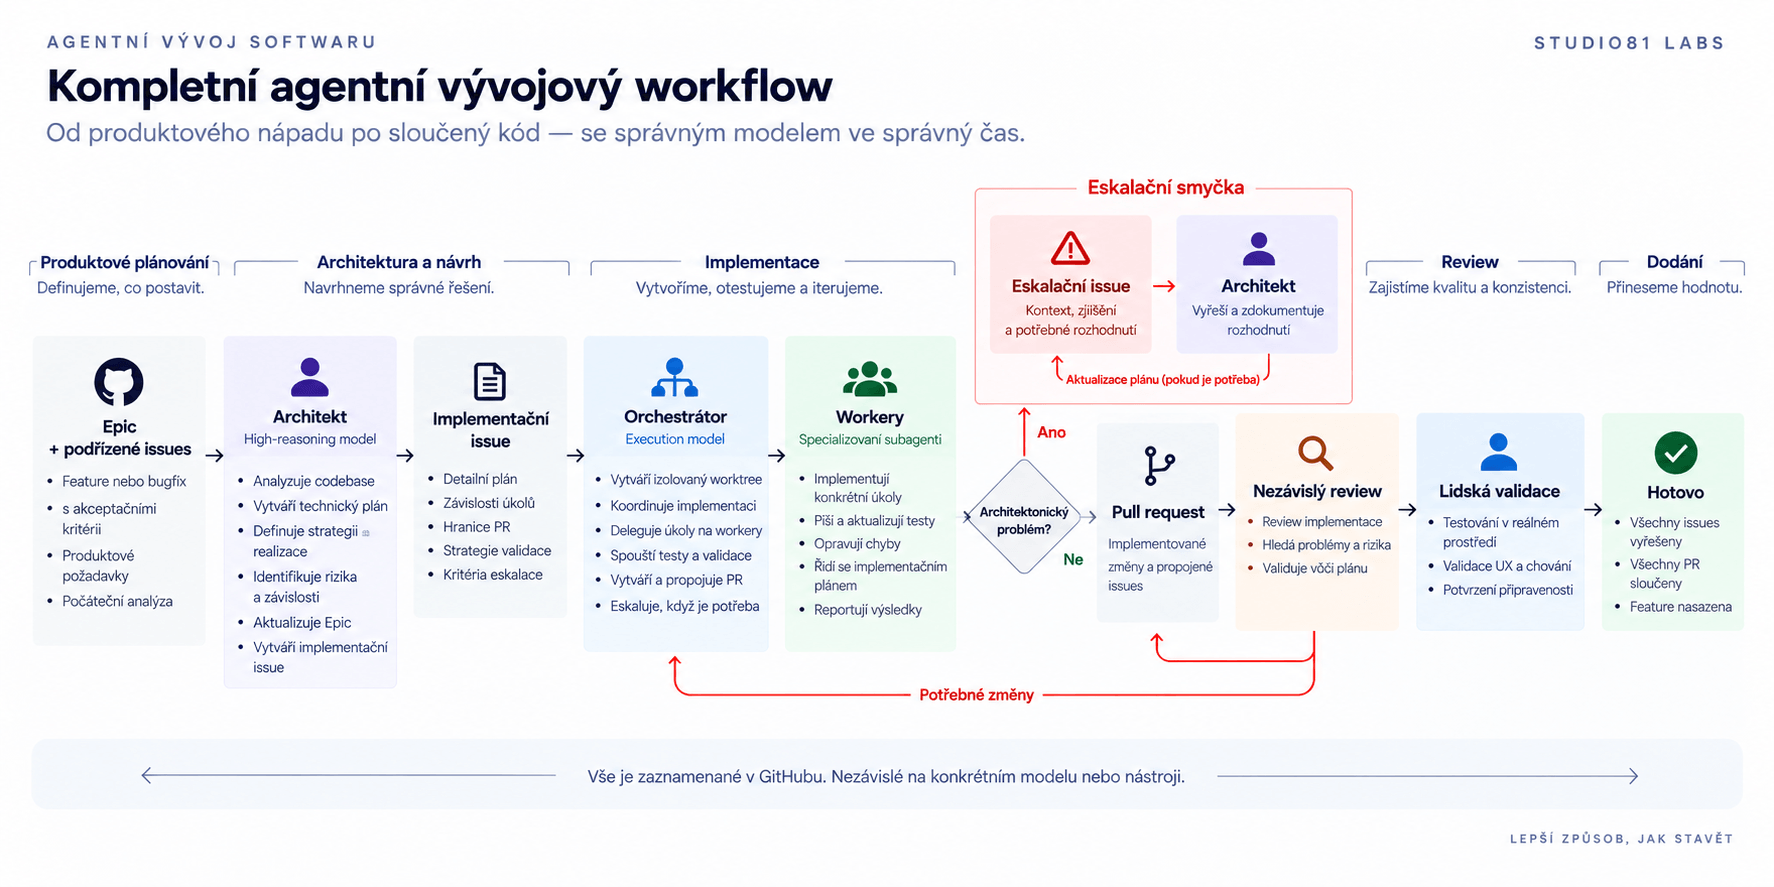
Výsledný workflow
Tři prompty místo jednoho obrovského promptu
V praxi už nepotřebujeme jeden obrovský prompt, který po agentovi požaduje vlastnictví celého lifecycle. Potřebujeme tři opakovaně použitelné vstupní body. Artefakty mezi nimi žijí v GitHubu, nikoliv v historii konverzace. A to je záměr.
1. Naplánuj Epic. Dostaneš GitHub Epic a jeho child issues. Projdi skutečnou codebase, navrhni technickou implementaci, urč dependencies, zvol serial/parallel/hybrid execution, definuj hranice PR a validační/escalation criteria, aktualizuj Epic a vytvoř implementation issue. Neimplementuj.
2. Implementuj plán. Dostaneš implementation issue. Přečti parent Epic a technický plán, vytvoř izolovaný workspace, realizuj dependency graph, deleguj jasně ohraničené úkoly, vytvářej a propojuj PR, prováděj validaci a zásadní architektonické gaps eskaluj namísto improvizace.
3. Vyřeš eskalaci. Dostaneš escalation issue. Projdi původní plán a relevantní kód, proveď deep reasoning nad konkrétním problémem, zaznamenej rozhodnutí, v případě potřeby aktualizuj Epic a přesně urč, odkud může orchestrátor pokračovat.
Modely musí být nahraditelné
Náš současný toolset zahrnuje Claude Code, Codex a Antigravity a modely vybíráme podle typu práce: high-reasoning modely pro architekturu, rychlejší modely jako plnohodnotné orchestrátory, menší modely jako workers pro ohraničené úkoly a jinou modelovou rodinu pro nezávislé review. Žádný z těchto konkrétních názvů ale nepatří do architektury samotného vývojového procesu. Zdravý workflow by měl umožnit používat dnes:
Sol → Sonnet → Codex review
a zítra:
Opus → Gemini → jiný reviewer
Repository, product specification, GitHub issues, pull requesty a zaznamenaná rozhodnutí jsou trvalé. Model je nahraditelný výpočetní prostředek.
Programování se posunulo ke správě omezení
Největší změnou, kterou AI agenti přinesli do našeho vývojového procesu, není to, že píšeme méně kódu. Je to skutečnost, že se větší část naší engineering práce posunula o jednu úroveň výš. Definujeme produktová omezení. Definujeme architektonické hranice. Rozhodujeme, která rozhodnutí může implementační agent dělat autonomně a která musí eskalovat. Rozhodujeme, kde má paralelizace smysl a kde se vyplatí použít drahý reasoning. Kontrolujeme výstup a ověřujeme ho proti realitě. Agenti stále častěji zajišťují samotnou exekuci uvnitř těchto hranic.
Agentní vývoj softwaru se tím stává méně otázkou hledání jediného nejchytřejšího coding modelu a více otázkou návrhu systému, ve kterém dokáže spolehlivě spolupracovat několik různých modelů.
Což se překvapivě podobá samotnému navrhování softwaru.
— Studio81